



3 chaires Synergie
3 chaires "Synergie"
Les chaires « Synergie » font partie des programmes de recherche en intelligence artificielle pilotés par l’Institut DataIA. Ce dispositif de chaires vise à soutenir et à coordonner les projets scientifiques menés par des chercheurs et des enseignants-chercheurs au sein de l’écosystème DataIA.
Une chaire de recherche rassemble des chercheurs, des partenaires socio-économiques et des ressources dédiées afin de traiter un enjeu commun. Sur une période d’environ trois ans, elle vise à mener des recherches scientifiques de haut niveau, tout en favorisant l’innovation, la formation et le transfert de connaissances. Les chaires « Synergie » sont également conçues pour servir de véritable lieu de collaboration entre le monde universitaire et les acteurs des secteurs public ou privé.
Lancés en mars 2025, ces projets rassemblent huit chercheurs, qui bénéficient chacun d'une subvention de 300 000 €, afin de mener des recherches scientifiques sur les thèmes suivants :
« Modèles pré-entraînés pour la Frugalité des Données dans le domaine de la santé »
Pre-trained Models for Data Frugality in Health
Florent Bouchard Chargé de recherche CNRS et CentraleSupélec (laboratoire L2S)
Edouard Duchesnay Directeur de recherche au CEA (NeuroSPIN)
Les « modèles pré-entraînés pour la frugalité des données » sont des modèles d'intelligence artificielle déjà entraînés sur de grandes quantités de données, puis ajutés à des contextes où les données disponibles sont limitées.
Ils permettent ainsi d'obtenir de bonnes performances sans avoir besoin de collecter énormément de nouvelles données, ce qui est particulièrement utile dans des domaines comme la santé ou la recherche scientifique.
Un défi récurrent dans le domaine de l'IA appliquée à la santé est le manque de données d'entraînement, compte tenu de leur coût ou des questions de protection de la vie privée (RGPD). Par conséquent, ce sont souvent des modèles d'intelligence artificielle simples, plutôt que des architectures complexes, qui dominent le machine learning dans le domaine de la santé. Le paradoxe est que nous avons accès à d'abondantes données médicales provenant d'une multitude de centres de recherche ou d'hôpitaux. Mais le rassemblement des données échoue souvent : les ensembles de données sont trop hétérogènes et leur interopérabilité est limitée. Et les hôpitaux ne veulent pas les partager car ils ont compris aussi la valeur de leurs données ! De plus, seul un petit sous-ensemble d'individus est généralement pertinent pour une question.
D'autres domaines liés à la science des données ont connu des avancées décisives grâce à l'utilisation de grands modèles de langues ou « modèles de fondation », pré-entraînés sur des données volumineuses et diversifiées, puis ajustés à des ensembles de données petits ou non étiquetés.
Notre objectif est de mettre en œuvre cette stratégie pour les données médicales : pré-entraînement pour l'apprentissage en quelques essais (pre-training for few-shot learning).
Le projet rassemble donc des experts dans le domaine de l'apprentissage statistique afin de lever les obstacles liés à l'agrégation des données et à l'usage de modèles de pré-entraînés pour des tâches médicales [comme la classification de pathologies psychiatriques à partir de phénotypes de neuroimagerie]. La diversité des compétences permettra de disposer de modèles pré-entraînés pour des domaines variés en lien avec les données médicales, tels que la neuroimagerie ou l'échocardiographie, afin de les exploiter pour des tâches médicales en aval (pronostic, segmentation d'images, interfaces cerveau-ordinateur, etc.).
« GenAI, Modèles de fondation : de la théorie aux applications »
Foundation Models: From Theory to Applications
Olivier Ferret Directeur de recherche au CEA-List
Julien Randon-Furling Professeur des universités, ENS Paris-Saclay (Centre Borelli)
Maria Vakalopoulou Maîtresse de conférences à CentraleSupélec (laboratoire MICS)
Les « modèles de fondation » sont de grands modèles d'intelligence artificielle entraînés sur des volumes massifs de données hétérogènes (texte, image, son, etc.), capables d'être utilisés pour de nombreuses tâches différentes comme la segmentation, la classification, la traduction, la prédiction, etc.
Ils servent de base adaptable et peuvent être spécialisés ou ajustés pour répondre à des besoins précis sans repartir de zéro.
L'IA connaît actuellement un changement de paradigme avec l'essor rapide de modèles entraînés sur de grandes quantités de données, généralement à l'aide d'une auto-supervision, et pouvant être adaptés à un large éventail de tâches. Les modèles de fondation ont permis des avancées significatives dans les tâches de vision par ordinateur et de traitement automatique du langage naturel (NLP).
L'objectif principal de cette chaire est de fédérer la recherche au niveau mondial à Paris-Saclay afin de développer la prochaine génération de modèles de fondation ainsi que des modèles giga-génératifs (giga-generative models), en prenant une position de leader national et international, avec un accent particulier sur les applications dans le secteur médical. Le cœur de la chaire combinera une expertise en deep learning, en processus de diffusion, en NLP et en imagerie médicale, créant ainsi de fortes synergies selon trois axes convergents :
- Développements théoriques.
- Modèles de fondation pour l'imagerie médicale.
- Natural language foundation models pour l'imagerie médicale.
« L'IA pour l'enseignement et l'apprentissage à grande échelle »
ATLAS – AI for Teaching and Learning (AI) at Scale
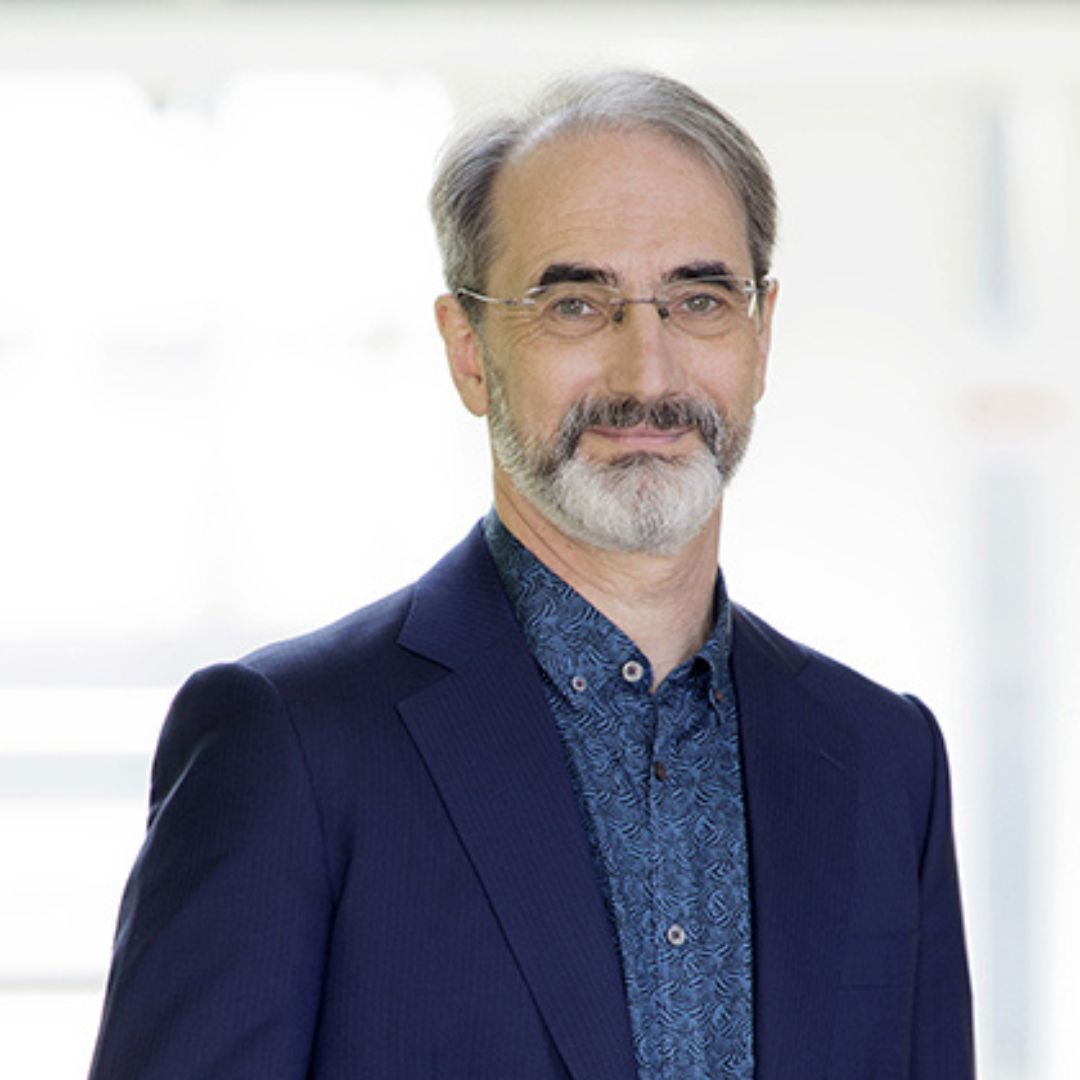
Michel Beaudouin-Lafon Professeur des universités, Université Paris-Saclay, membre de l'Académie des sciences
Nicolas Théry Professeur des universités, Université Paris-Saclay (laboratoire LISN)
L'éducation est confrontée à un double défi avec l'IA : d'une part, comment enseigner l'IA et la pensée computationnelle à grande échelle afin de former les experts, les scientifiques et les citoyens qui façonneront notre avenir ; d'autre part, comment intégrer l'IA dans les pratiques d'enseignement et d'apprentissage afin qu'elle renforce les capacités des éducateurs et des apprenants plutôt que de les menacer ou de les déqualifier.
Ce projet réunit des chercheurs en conception « Human-Centric Design » (dirigés par Michel Beaudouin-Lafon) et en apprentissage adaptatif (dirigés par Jill-Jênn Vie). La stratégie principale consistera à mettre en place une boucle vertueuse étroite et agile entre la recherche, la technologie et la pratique pédagogique : observer et évaluer les besoins et les pratiques des enseignants et des apprenants, exploiter les méthodologies et technologies existantes et en développer de nouvelles, les déployer sur le terrain, les évaluer et alimenter la poursuite de la recherche et le développement technologique.
Ces travaux seront réalisés en collaboration avec des partenaires internationaux, tels que le groupe de recherche KWARC à FAU Erlangen-Nürnberg (Allemagne), la Crowd Research Initiative à Stanford, le NYU-LEARN lab à l'Université de New York et le Kashima Lab à Kyoto.
Les résultats comprendront des publications, des contributions aux outils existants, mais aussi de nouveaux outils innovants, du matériel de formation et des pratiques exemplaires. Le succès sera mesuré par l'évaluation de la pertinence et de l'impact sur l'apprentissage (études auprès des utilisateurs à différentes échelles), les publications, l'adoption d'outils, le matériel de formation et les pratiques exemplaires, ainsi que l'évaluation de l'impact environnemental.
Pour cela, merci de nous contacter par mail : submission-dataia@inria.fr